El campo del Machine Learning ha transformado radicalmente la manera en que procesamos la información y tomamos decisiones estratégicas en la era digital actual, convirtiéndose en el motor principal de la innovación tecnológica contemporánea en múltiples industrias globales.
Hoy en día, el Machine Learning permite a las empresas automatizar tareas repetitivas, optimizar procesos operativos complejos y descubrir patrones ocultos dentro de grandes volúmenes de datos comerciales que antes resultaban imposibles de analizar manualmente por los equipos humanos.
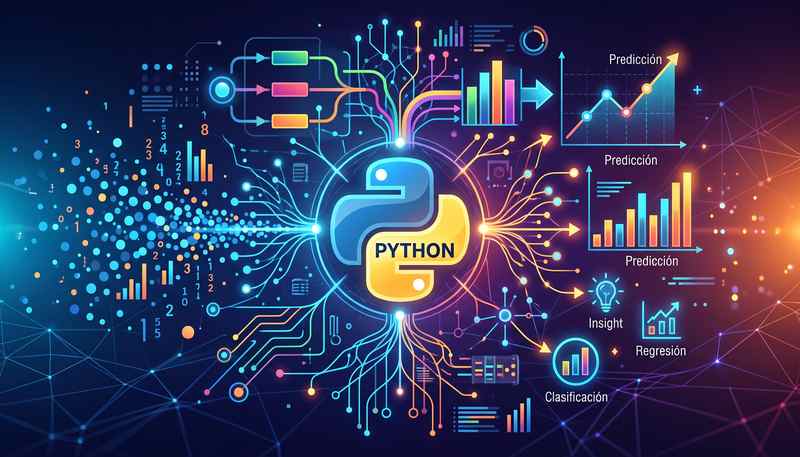
Dentro de este ecosistema tecnológico en constante expansión, el Machine Learning cuenta con el lenguaje Python como la herramienta favorita, versátil e indiscutible de los científicos de datos, ingenieros de software y analistas de negocios en todo el mundo.
Comprender los fundamentos teóricos y prácticos de los algoritmos predictivos en proyectos de Machine Learning es el primer paso indispensable para dominar esta disciplina con total seguridad y aplicarla de manera exitosa en escenarios profesionales reales y altamente competitivos.
¿Qué es el Machine Learning y por qué Python?
El Machine Learning es una rama avanzada de la inteligencia artificial que dota a los sistemas informáticos de la capacidad de aprender de forma autónoma a partir de la experiencia previa, sin necesidad de ser explícitamente programados para cada regla específica.
Python se posiciona indiscutiblemente como el lenguaje líder para desarrollar proyectos de Machine Learning gracias a su sintaxis sumamente limpia, legible y natural, lo que reduce drásticamente la curva de aprendizaje para los nuevos programadores que ingresan al sector.
Además, este popular lenguaje ofrece bibliotecas especializadas que facilitan la implementación de proyectos de Machine Learning desde cero con gran eficiencia operativa. Puedes consultar más detalles oficiales directamente en la documentación de Python
.
La flexibilidad y el rendimiento que aporta este lenguaje aseguran que cualquier desarrollo relacionado con el Machine Learning pueda escalar sin inconvenientes desde prototipos académicos pequeños hasta soluciones empresariales masivas y robustas.
Principales tipos de aprendizaje automático
El aprendizaje supervisado es una de las modalidades más utilizadas en Machine Learning para realizar predicciones precisas basadas en datos históricos que ya han sido previamente etiquetados por expertos o sistemas automatizados de clasificación confiables.
En este enfoque metodológico, el algoritmo recibe un conjunto de entradas junto con las respuestas correctas deseadas, ajustando sus parámetros internos de manera iterativa hasta minimizar al máximo el error general entre la predicción y el valor real.
Por otro lado, el aprendizaje no supervisado dentro del Machine Learning busca encontrar estructuras ocultas, agrupaciones naturales o anomalías en conjuntos de datos que carecen por completo de etiquetas o clasificaciones previas proporcionadas por intervención humana.
Este método específico resulta verdaderamente ideal para tareas avanzadas de segmentación de clientes y análisis de mercado, donde el objetivo principal es agrupar elementos con características similares sin conocer las categorías de antemano.
Librerías esenciales para desarrollar modelos
Scikit-learn es una biblioteca fundamental, robusta y sumamente confiable para cualquier profesional que trabaje activamente con algoritmos clásicos de Machine Learning en entornos de producción corporativa que exigen alta velocidad y estabilidad.
Esta herramienta proporciona implementaciones altamente eficientes para tareas de clasificación, regresión, análisis de conglomerados y reducción de dimensionalidad utilizando una interfaz unificada, consistente y muy fácil de integrar en scripts existentes.
Por su parte, TensorFlow y PyTorch lideran de forma absoluta el desarrollo de redes neuronales profundas dentro del campo del Machine Learning avanzado, el procesamiento de lenguaje natural y la visión artificial moderna.
Estas potentes bibliotecas aprovechan al máximo la capacidad de cálculo paralelo de las unidades de procesamiento gráfico para acelerar de manera drástica el entrenamiento de arquitecturas neuronales masivas y complejas.
El ciclo de vida de un proyecto predictivo
Cualquier iniciativa corporativa o de investigación basada en Machine Learning comienza obligatoriamente con una fase rigurosa de recopilación, limpieza, normalización y preparación de los datos en bruto disponibles en las fuentes originales de información.
Una mala calidad en los datos de entrada destruirá por completo el rendimiento predictivo de cualquier modelo, sin importar lo sofisticado o avanzado que este sea desde el punto de vista matemático y computacional.
La selección adecuada de características representa otro de los pilares fundamentales para garantizar que el algoritmo generalice correctamente ante información completamente nueva, desconocida y variada que provenga del entorno operativo real.
Una vez entrenado y validado el modelo, la fase de evaluación resulta crítica para medir su precisión utilizando métricas estándar como la matriz de confusión, la precisión, la sensibilidad y el área bajo la curva.
Desafíos comunes y mejores prácticas
El sobreajuste o overfitting representa uno de los mayores dolores de cabeza al implementar soluciones de Machine Learning en entornos empresariales reales, dinámicos y altamente cambiantes que manejan flujos continuos de datos nuevos.
Este problema técnico ocurre cuando el modelo memoriza excesivamente los detalles particulares del conjunto de datos de entrenamiento en lugar de aprender patrones generales, arruinando su desempeño predictivo posterior.
Para mitigar eficazmente este inconveniente, los desarrolladores suelen utilizar técnicas avanzadas de validación cruzada y aplicar métodos estrictos de regularización que limiten la complejidad innecesaria del algoritmo seleccionado.
Mantener la interpretabilidad y explicabilidad de los modelos también es un requisito vital para garantizar la absoluta transparencia, la ética y la confianza en las decisiones automatizadas que toma el sistema inteligente.
El futuro del Machine Learning continuará evolucionando rápidamente hacia sistemas cada vez más autónomos, energéticamente eficientes y accesibles para desarrolladores independientes que operan en múltiples industrias y sectores económicos globales.
La integración continua de estas tecnologías de Machine Learning en plataformas de computación en la nube facilitará aún más su adopción masiva sin necesidad de requerir infraestructuras de hardware físico excesivamente costosas.
Dominar estas herramientas y metodologías hoy en día te abrirá puertas excepcionales en el mercado laboral tecnológico, posicionándote de inmediato como un profesional altamente cotizado, versátil y perfectamente preparado.
Mantenerse constantemente actualizado con las últimas tendencias de la industria y practicar mediante el desarrollo de proyectos propios constituye la clave definitiva para triunfar en este sector tan apasionante.
Invertir tiempo de calidad en comprender a fondo las matemáticas subyacentes detrás de cada algoritmo te otorgará una ventaja competitiva diferencial frente a otros programadores que solo aplican código de forma mecánica.
La evolución constante de la inteligencia artificial promete transformar todavía más nuestro entorno profesional, haciendo que el dominio sólido de estas tecnologías sea absolutamente indispensable para alcanzar el éxito futuro.